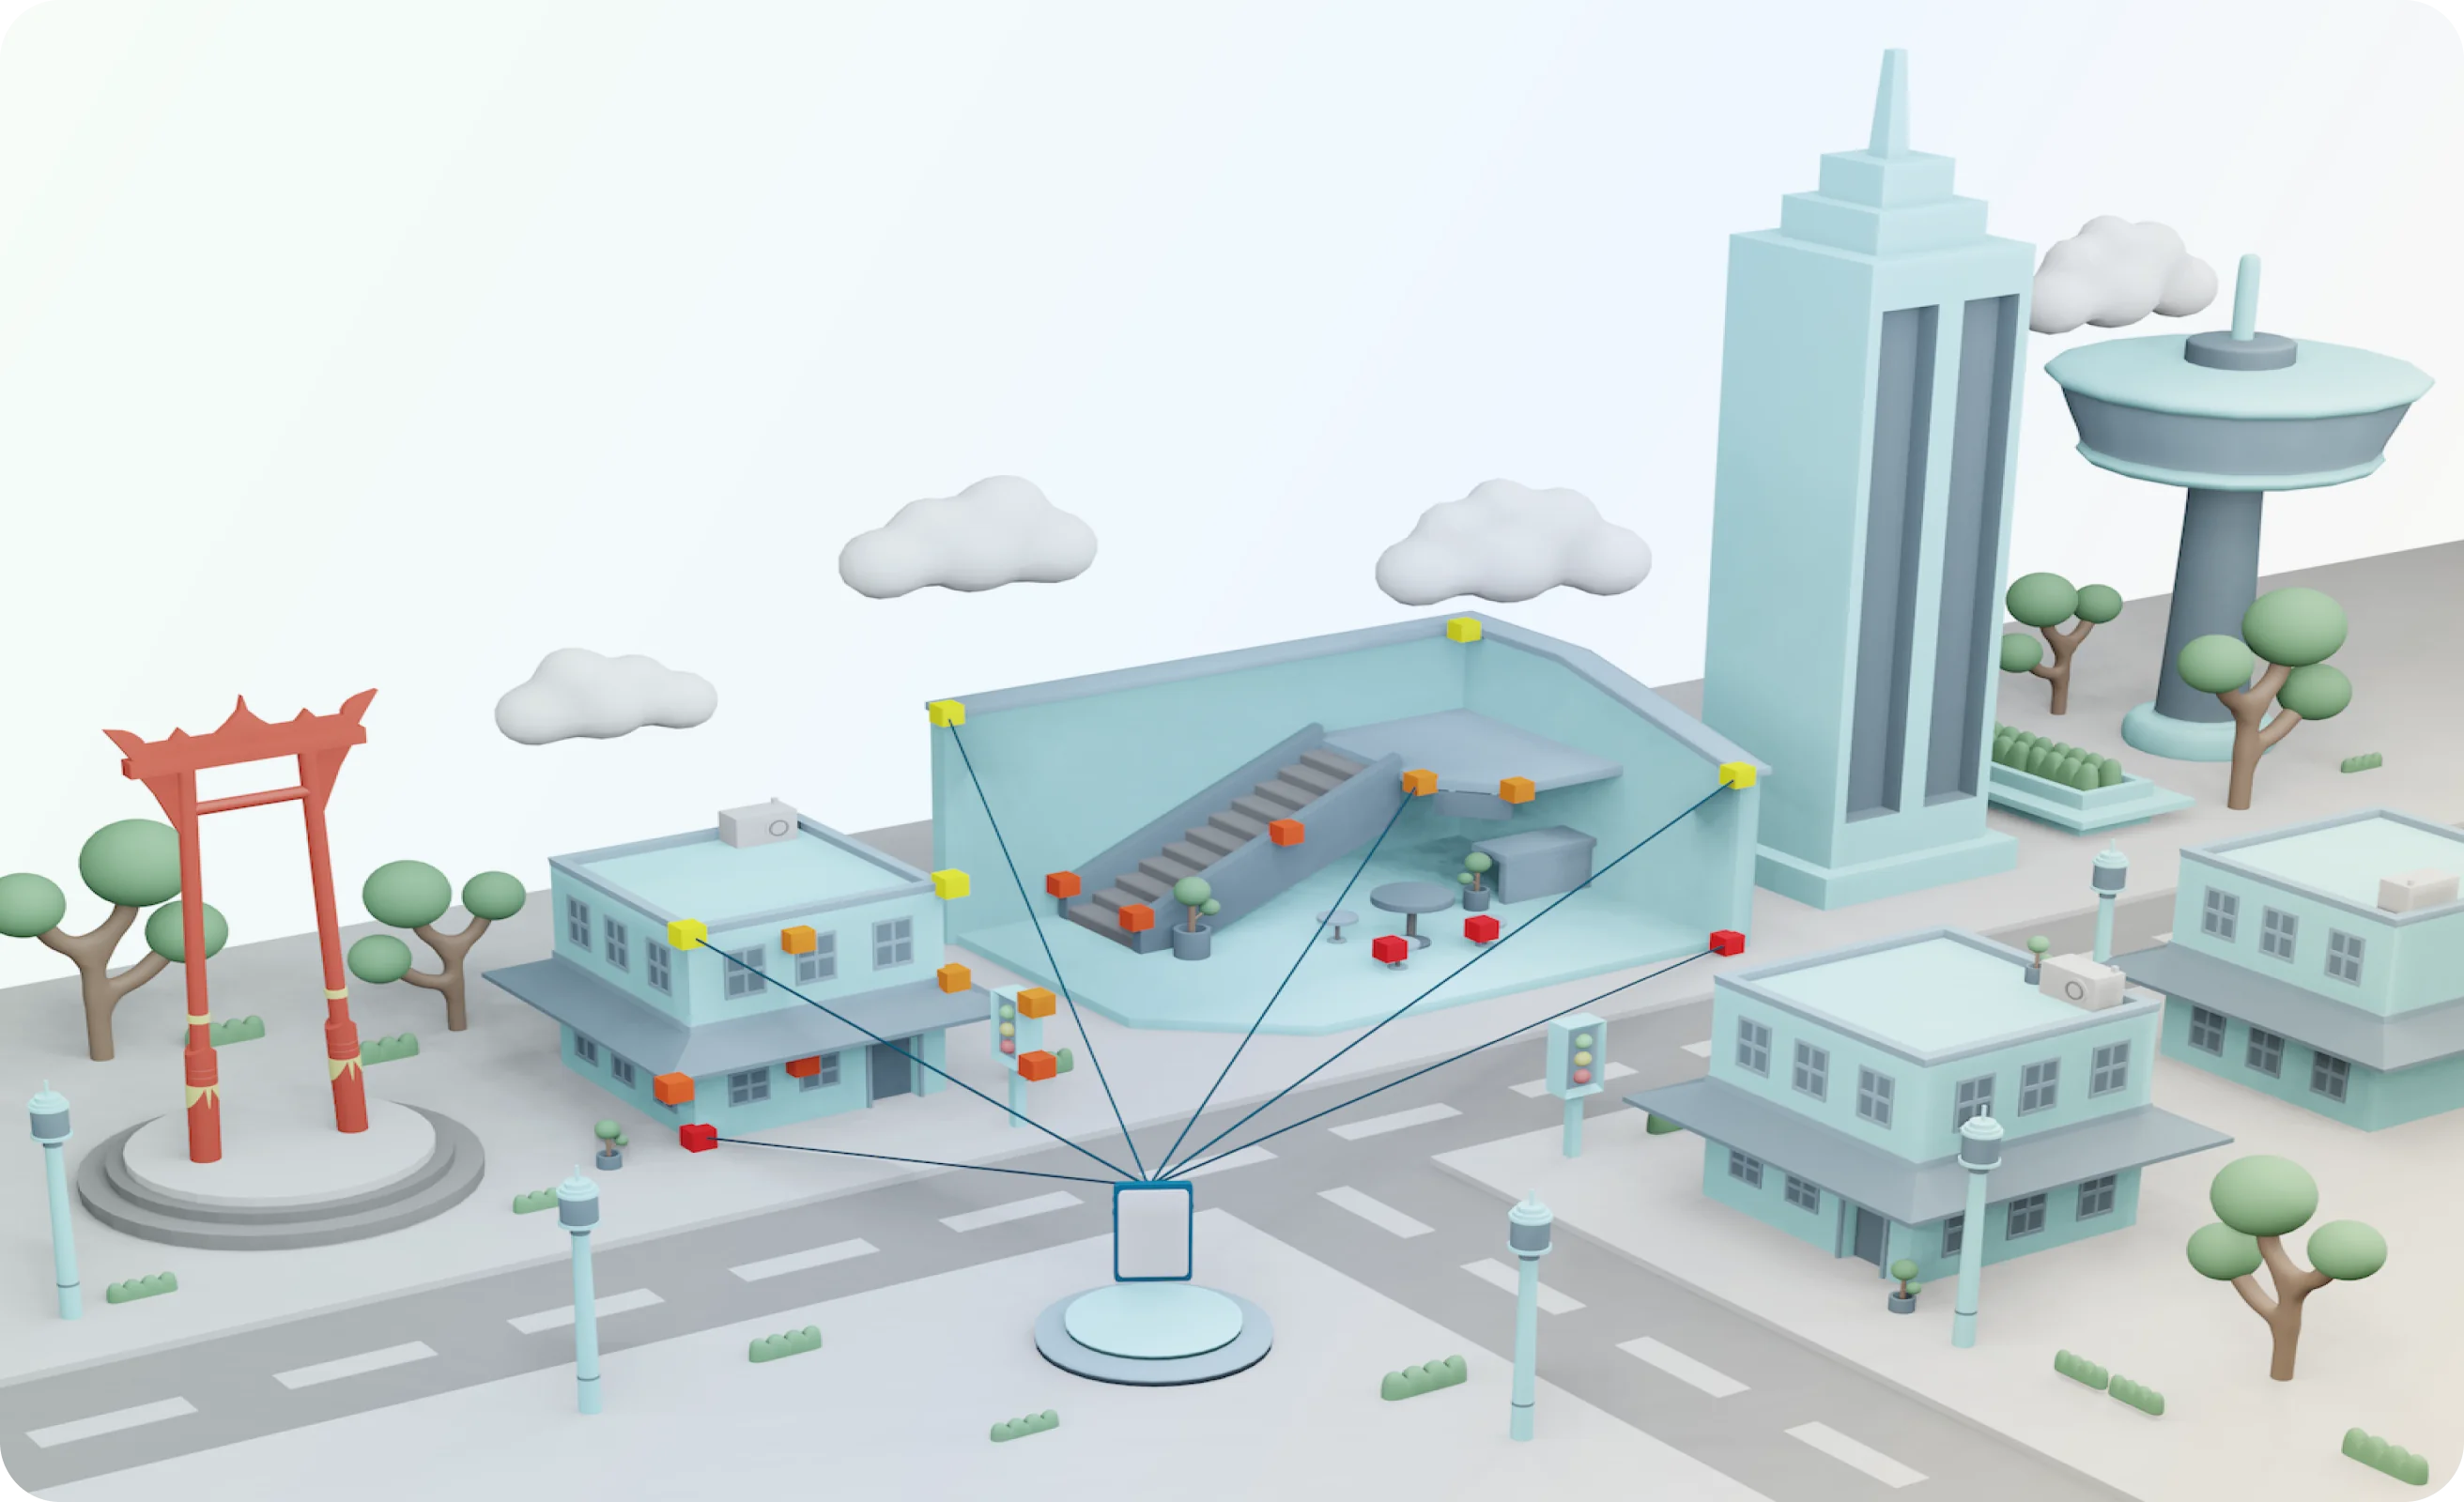
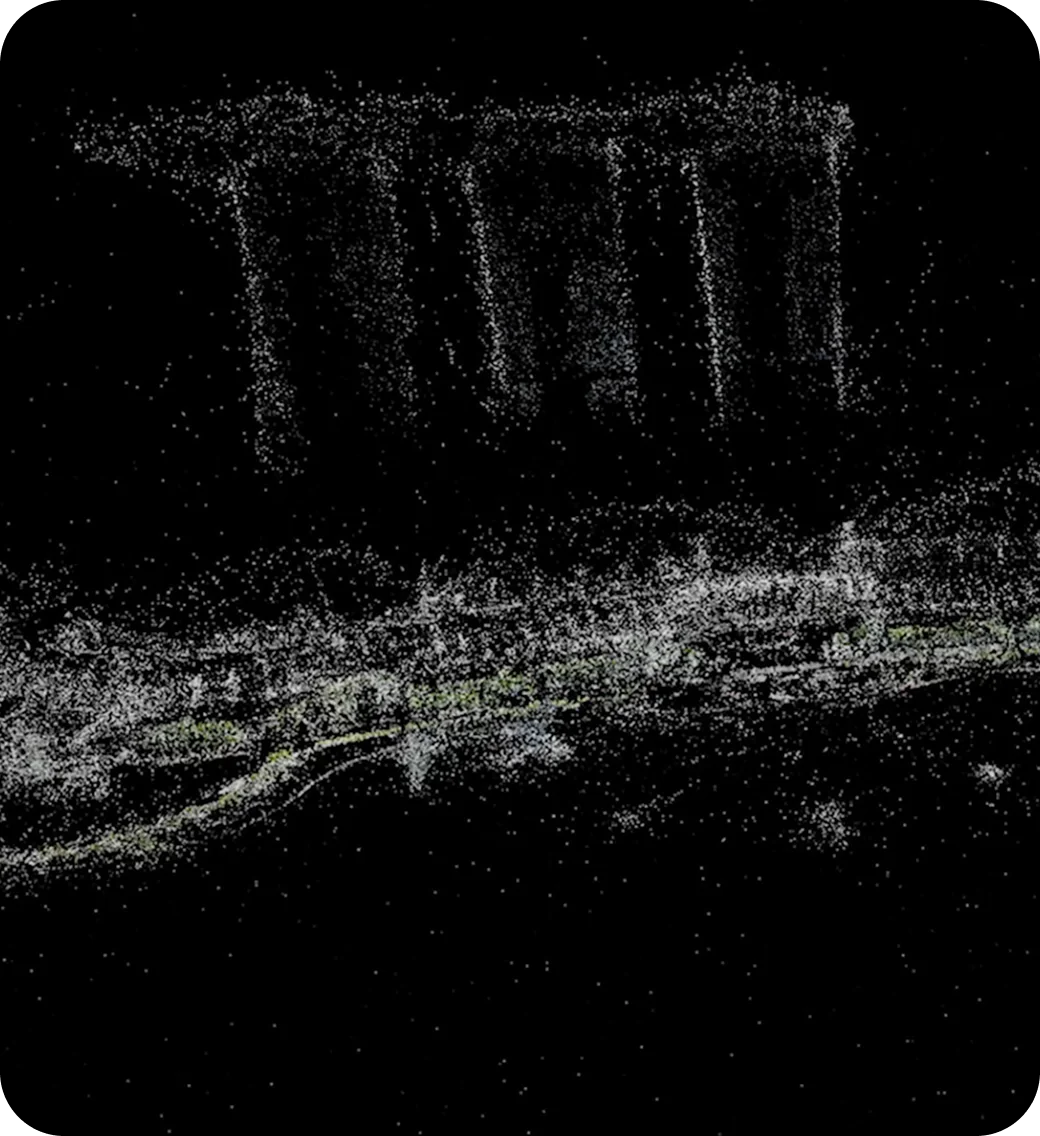
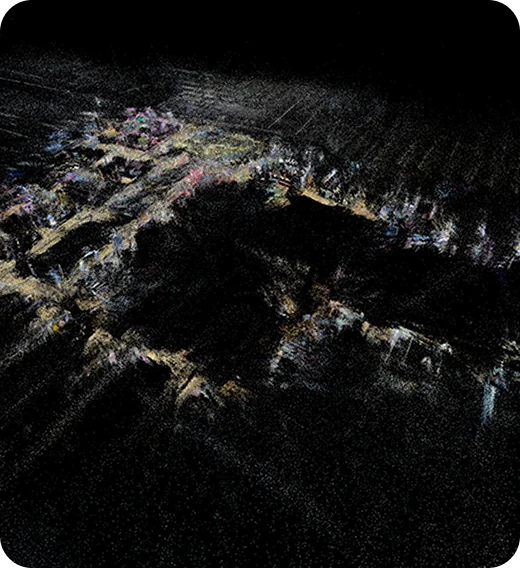
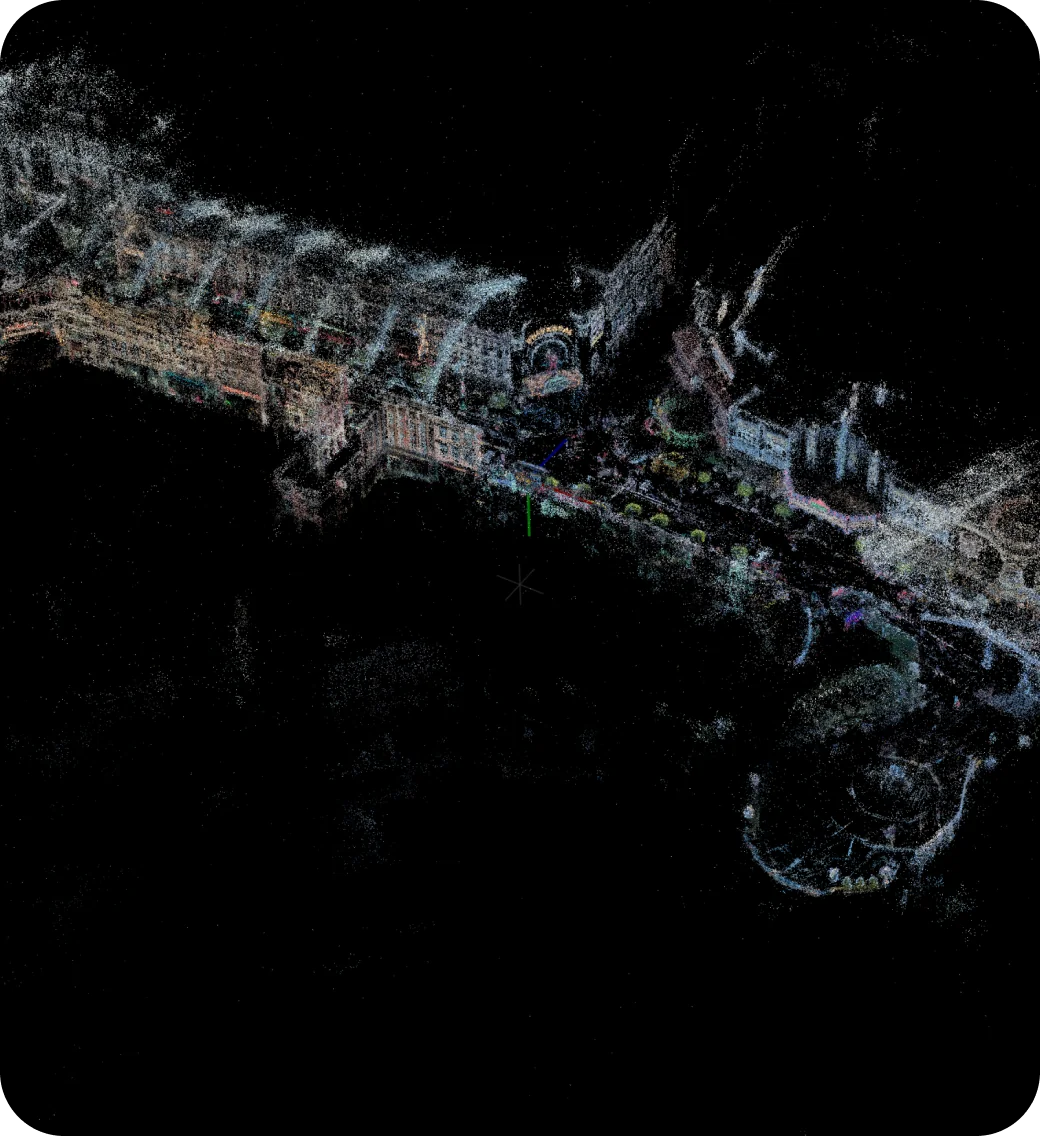
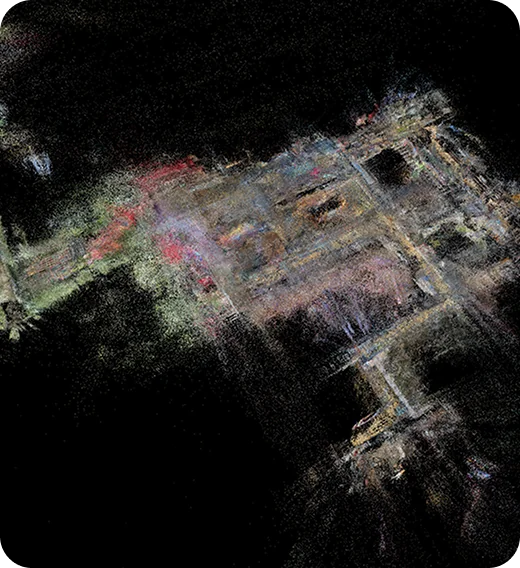
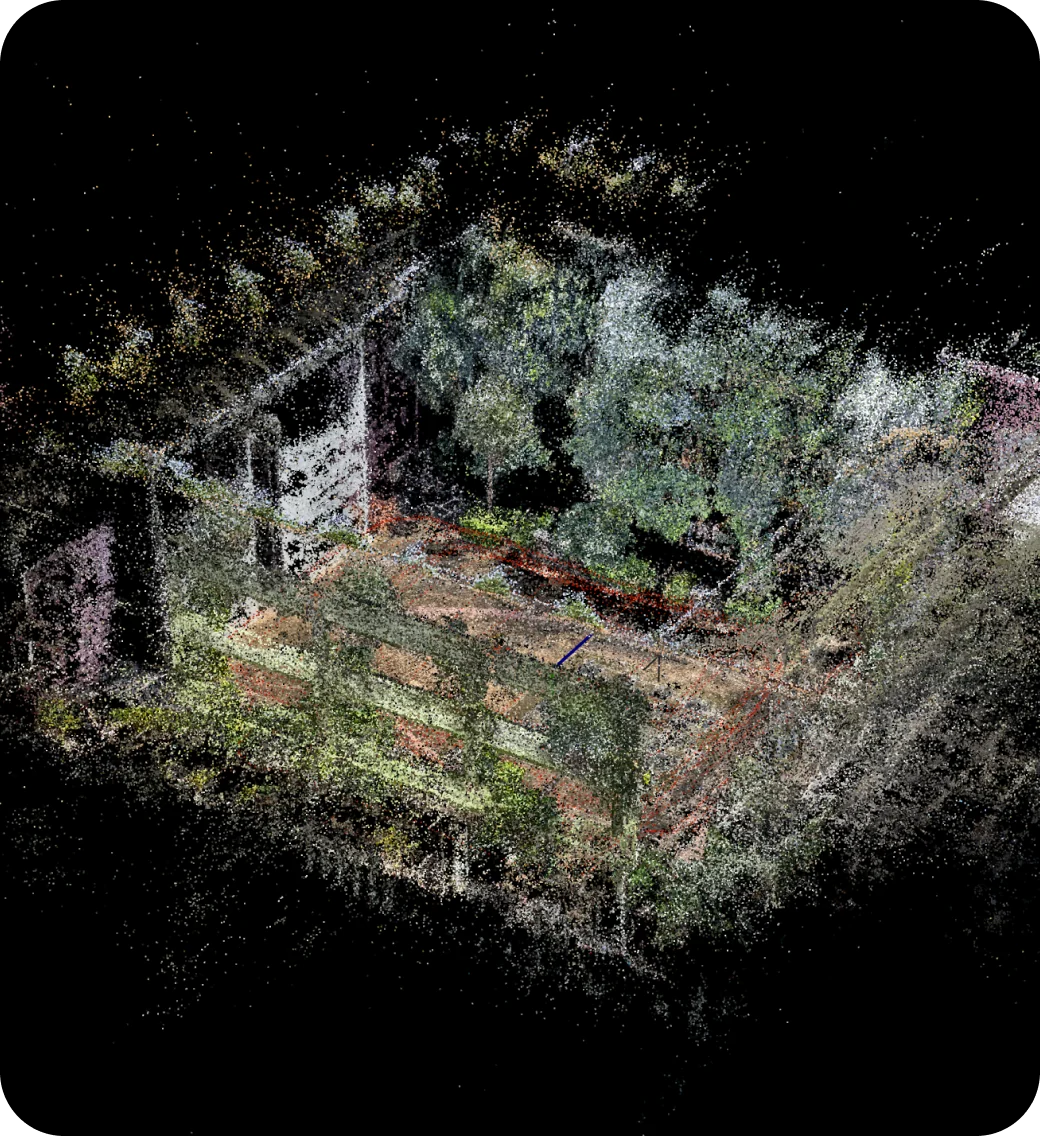
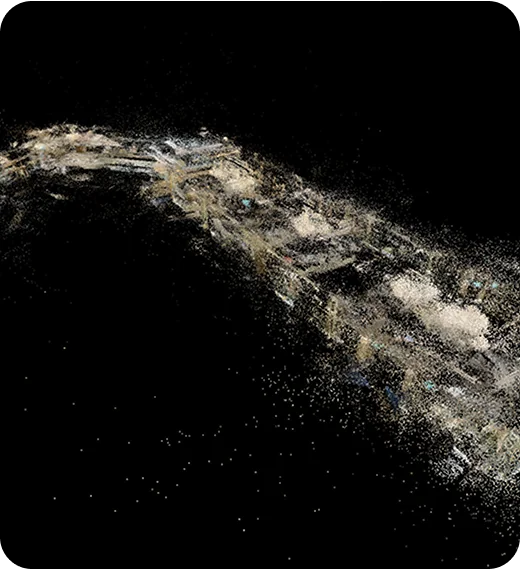
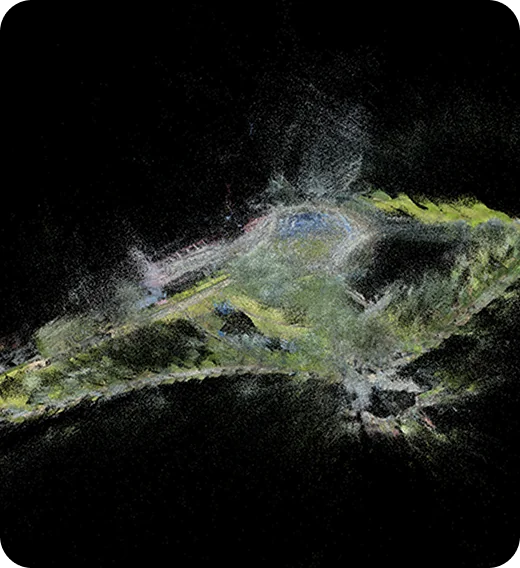
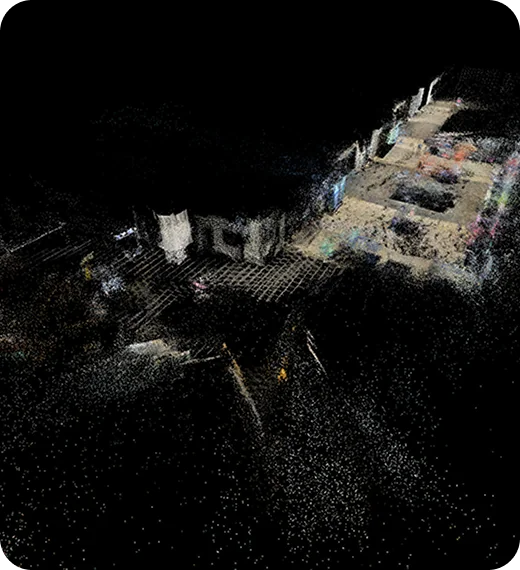
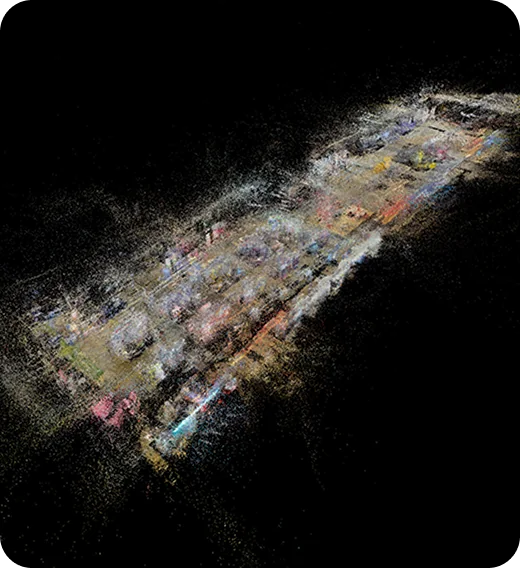
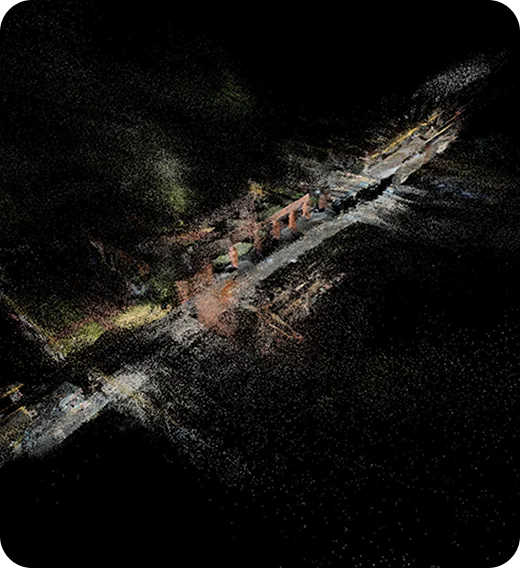
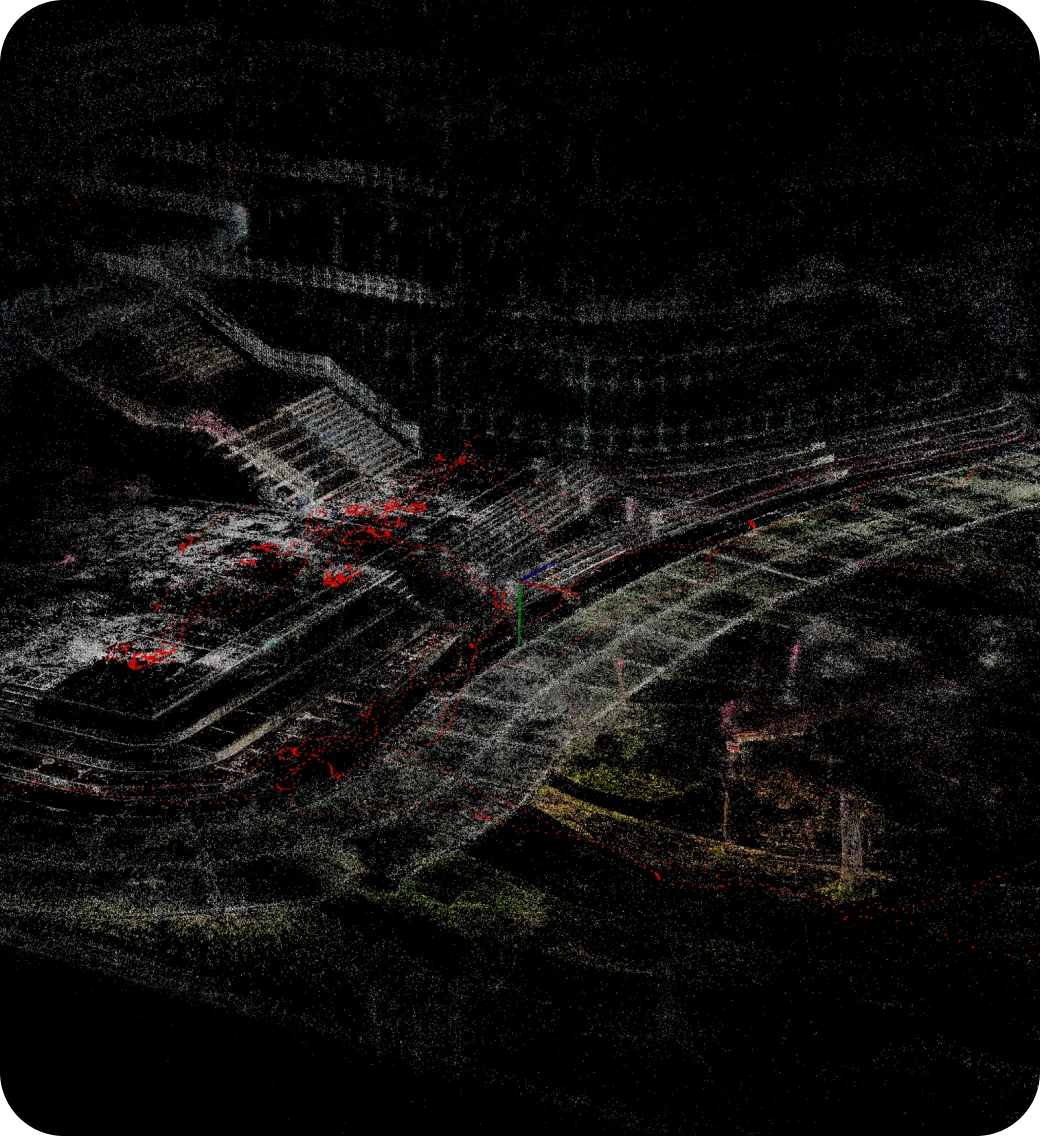
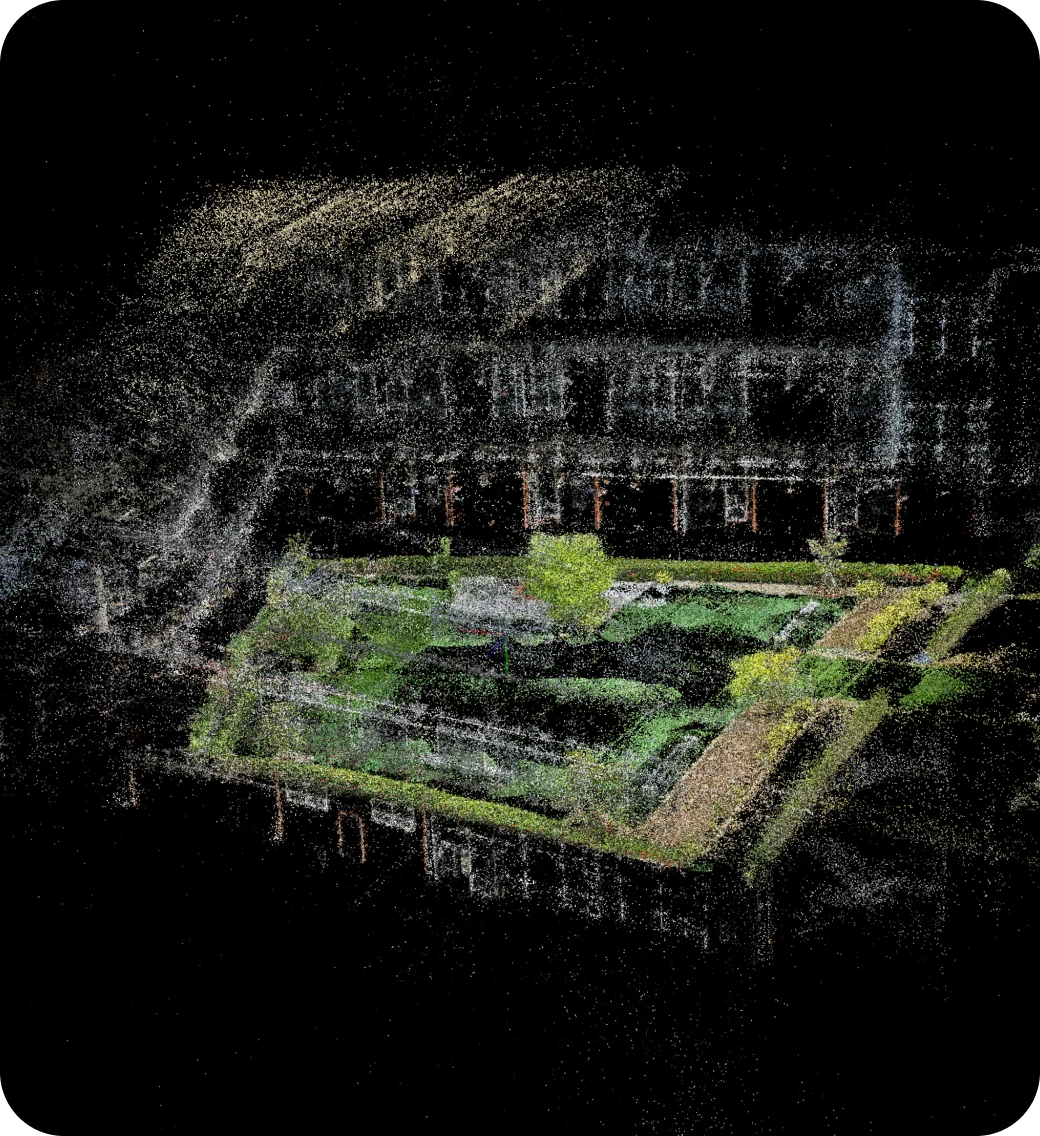
모든 Graffity 서비스는 동일한 4단계 Spatial AI 파이프라인을 기반으로 작동합니다. 공간을 일반 영상으로 촬영하면 Vision AI가 이를 3D PointCloud로 재구성합니다. 여기에 콘텐츠를 추가한 뒤, Visual Positioning System을 통해 현재 위치를 파악하는 기기에 제공합니다. GPS도, 비콘도, 벽에 붙이는 QR 마커도, 장소별 하드웨어 설치도 필요 없습니다.
운영자가 스마트폰의
Graffity Scanner로 벽면과 랜드마크를 비추며 공간을 걸은 뒤 촬영한 영상을 업로드합니다. 촬영은 전체 과정에서 비용이 가장 적게 들도록 설계했습니다. 측량팀이나 삼각대에 장착하는 전문 장비 없이 일반 스마트폰으로 공간을 한 번 촬영하면 됩니다.
업로드된 프레임은 Graffity의 ML 클러스터로 전송되어 장소의 고밀도 3D PointCloud로 재구성됩니다. 이 파이프라인은 장소마다 수작업하는 방식이 아니라 실제 운영 환경에 맞춰져 있어, 스캔 영상을 더 투입하는 것만으로 커버리지가 넓어집니다. 새로운 쇼핑몰이나 캠퍼스를 추가하는 일은 엔지니어링 프로젝트가 아니라 스캔 작업입니다.
완성된 PointCloud는
Graffity Console에서 열리며, 크리에이터는 관심 지점(POI)과 앵커를 3D 지오메트리 위에 바로 배치하고, 프로젝트를 관리하며, 팀과 협업합니다. 작업 중인 결과물은 Console에 표시된 QR 코드를
Graffity Viewer로 스캔해 현장에서 확인할 수 있으므로, 게시 전에 실제 공간에서 디자인을 검증할 수 있습니다.
실행 시 Visual Positioning System이 기기 카메라에 보이는 장면을 저장된 PointCloud와 대조해 기기의 위치와 방향을 6자유도(6DoF)로 추정합니다. HTTP/2를 통해 반복되는 위치 추정 요청을 하나의 연결로 연속 전송하므로 요청이 대기열에 쌓이지 않습니다. 경로, 라벨, 콘텐츠는 배치한 바로 그 자리에 나타납니다. 센티미터급 위치 측정은 로봇과 자율 기계가 길을 찾는 데에도 필요한 기술입니다. Graffity는 이를 바탕으로 Physical AI를 위한 기술을 발전시키고 있습니다.